Технологии
Цифровой мир, как он есть, и немного, каким должен быть
Рубрикатор
Последние записи
Гемы is-module-reset и is-deep
Вообще-то я сначала собирался написать только про is-module-reset, но понял, что без упоминания ключевой зависимости — is-deep — а главное, ограничений, с нею связанных, обойтись никак нельзя.
И ключевое ограничение — это категорическая несовместимость с activesupport, поскольку is-deep
monkey-патчит те же методы (с теми же целями но полностью другим способом)… Возможно, я когда-нибудь придумаю другие имена,
но пока не знаю, чем корректно и идиоматично заменить deep_merge.
Начнем с того, что попроще.
is-module-reset
Собственно, задача, которая передо мной встала: это тестирование плагинов для Jekyll, в частности —
jekyll-is-hookdown,
о котором я писал ранее. Проблема возникает, в первую очередь, с тестированием хуков, поскольку Jekyll не предоставляет возможности
их дерегистрации, и пересоздание объекта сайта тут не помогает, поскольку хуки хранятся в переменных модуля Jekyll.
Соответственно, новый гем тем и занимается, что сохраняет и восстанавливает внутреннее состояние модулей (и классов). Интерфейс простой:
dump(*mods)-
Копирует данные модулей, возвращая
Hash, который затем можно использовать для восстановления. undump(hash)-
Восстанавливает ранее сохраненные данные. Очевидным образом
dumpиundumpиспользуются в паре. isolate(*mods) { ... }-
Сохраняет данные указанных модулей, выполняет блок кода, восстанавливает сохраненные данные обратно.
Сохраняются только переменные объекта указанных классов и модулей и переменные класса, причем последние — только принадлежащие непосредственно указанному классу или модулю, а не унаследованные им. Что это такое и в чем разница, можно посмотреть в моей давней статье. Константы не сохраняются, чтобы не вызывать лишних предупреждений. Если у вас где-то меняется содержимое констант-контейнеров, это нужно учитывать и обрабатывать как-то иначе.
Тут я хочу подчеркнуть, что гем предназначен для использования только в тестах и не обеспечивает полноценной изоляции контекста. Это не средство для создания «песочницы» или чего-то подобного в рабочих задачах.
Данные копируются через deep_dup, со всеми его ограничениями. И тут самое время перейти к следующему гему…
Чо там у Suno?
В продолжение наведения порядка со ссылками… Раз уж начал, зашел на, собственно, Suno, а там обновления и прочая веселуха. Причем я как раз успел застать состояние перед переходом на модель v6 и попробовать модели v4.5 (ее бесплатный вариант) и немного v5.5 (в промо-режиме).
Для более-менее основательных выводов я повозился с этими моделями недостаточно, могу лишь субъективно сказать, что v5.5 мне скорее понравилась, а бесплатная ветка v4.5 — не понравилась совсем. Про действующую v6 (в части бесплатной v6-mini) ниже скажу подробнее.
Ссылки
В апдейт к предыдущему посту: сейчас списки под текстами — в обратном хронологическом порядке вместо прямого, при этом сначала идут треки на русском, потом переводы. По клику на иконке наушников «🎧» можно перейти на страницу данного трека на Suno, а по клику на иконку листа бумаги «📄» (если она есть) — на страницу текста на этом сайте. Тексты переводов я пока на сайт не заносил…
Все тексты, к которым есть suno-озвучка можно найти через категорию Suno.
Плагины jekyll‑is‑hookdown и jekyll‑is‑images v0.8.2
jekyll-is-images
Сначала коротко про jekyll-is-images. По сравнению с состоянием на прошлый пост в основном
произошло много мелких правок мелких багов, из относительно существенного — довел до ума работу галерей в режиме слайд-шоу (впрочем, и там
есть куда расти). А третью цифру я поднял при смене зависимости с is-kramdown-hooked
на jekyll-is-hookdown, о котором и поговорим далее. Это повлияло на то, что следует указывать
в _config.yml — вместо input: ISKram в подразделе kramdown следует указывать markdown: Hookdown в корне конфига. А подраздел
kramdown остается полностью рабочим, и там можно указывать любой input, например — GFM1 (что я и собираюсь сделать на сайте
в ближайшее время).
jekyll-is-hookdown
Итак, что же это такое? Это специальный гем, который «хакает» процесс обработки markdown в Jekyll, добавляя хук на тот момент, когда страница уже распарсена во внутреннее AST-представление и еще не преобразована во что-то другое. Зачем это надо? Чтобы не делать лишней работы по парсингу исходного markdown или финального HTML.
-
GitHub Flavored Markdown. Конкретно мне это нужно для того, чтобы использовать ``` (тройной бэктик) для блоков кода вместо окружения {% highlight %}. ↩
Ссылки на Suno
Давно собирался, наконец-то сделал — ссылки на мои опыты в Suno, непосредственно со страниц соответствующих текстов. Нужно, конечно, сделать еще нормальные плейлисты и альбомы, но это потом. И, конечно, надо делать нормальную верстку… И это как раз в процессе, вместе с прочим рефакторингом и редизайном.
Пока можно посмотреть список омузыкаленных текстов по тегу «suno».1
Пока просто списки в хронологическом порядке, без отделения того, что мне самому понравилось от особо упоротых экспериментов…
-
См. изменения в последующем посте. ↩
Плагин jekyll-is-images v0.8.0.2
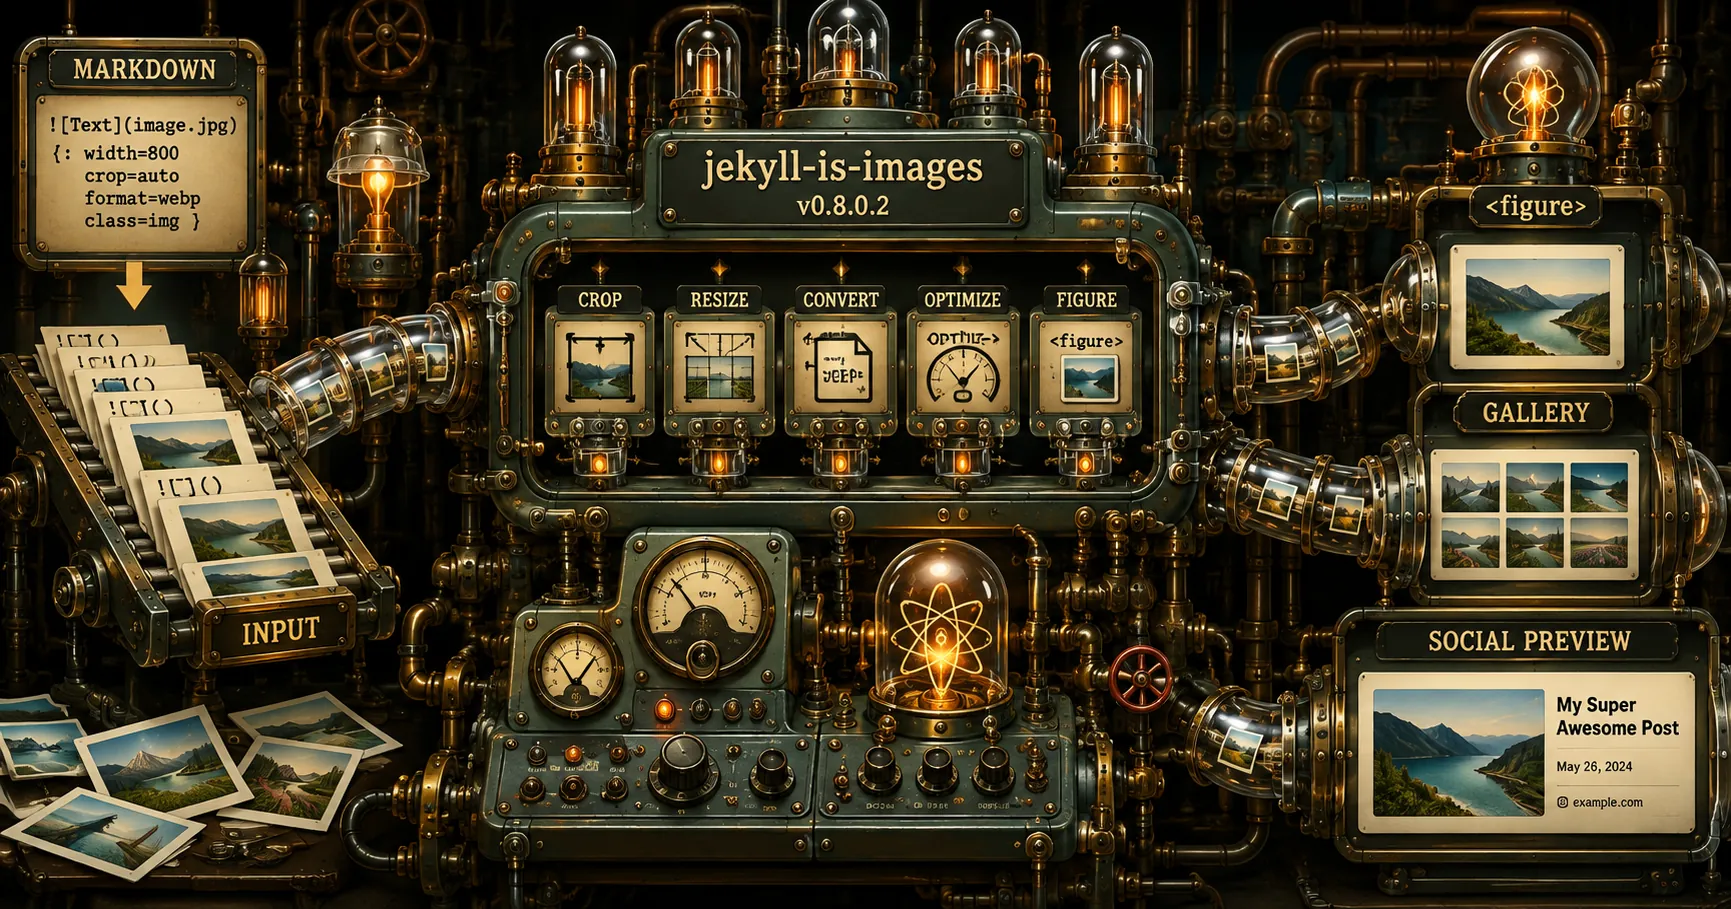
Сделал таки плагин для Jekyll, реализующий именно то, и именно так, как мне надо…
Коротко суть: картинки обрезаются, ресайзятся и конвертируются в зависимости от параметров, и далее заворачиваются в теги
<figure>. Более того, легко и непринужденно из этих картинок формируются галереи, которые тоже можно всячески кастомизировать.
Подробности можно почитать в README-ru проекта на Github. Здесь коротко.
Зависимости и ограничения
-
Требуется ImageMagick
6-й или7-й версии. И это та зависимость, которая не подтягивается черезbundle installпо понятным причинам. -
Полноценно плагин будет работать, только если в качестве markdown-конвертера выбран Kramdown (это дефолтный выбор, так что, думаю, для большинства пользователей Jekyll — не проблема).
-
Кроме того, в настройках самого kramdown нужно выбрать кастомный парсер
ISKram, что может стать проблемой, если уже используется какой-то кастомный парсер…markdown: kramdown kramdown: input: ISKram
-
-
Запуск с нуля — при пустом кэше — это долго.
У меня получилось примерно 47 минут для этого сайта. Повторный запуск, когда кэш в наличии, занимает чуть больше полутора минут.
Далее о хорошем.
Синтаксис
Стандартный. Т.е. пишем, как это в Markdown принято, {: атрибуты } и радуемся. Вся кастомизация сидит в атрибутах
и контексте.
Если разметка рисунка сидит на отдельной строке, отбитая пустыми строками сверху и снизу, то она заворачивается не в <p>, как
это обычно делает Kramdown, а в <figure>.
Но самая магия начинается, когда у нас в одном абзаце несколько картинок, и нет ничего другого — в этом случае формируется галерея.
Можно, впрочем, использовать и liquid-теги {% image ... %} и {% gallery ... %},
как раз на тот случай, если нет возможности использовать Kramdown с кастомным парсером. Правда, Kramdown все равно подтянется
по зависимостям, и именно он будет разбирать параметры тегов.
Превьюшки для соцсетей
Штатно Jekyll позволяет указать картинку, которую соцсети будут использовать для превью. Плагин позволяет кропнуть и отресайзить эту картинку, а также накладывает на нее заголовок поста, дату и название сайта.
Кстати, именно это и занимает большую часть времени работы — формирование и наложение текста ImageMagick’ом.
Статус и планы
Текущая версия — 0.8.0.2, т.е., как и все 0.8.xxx у меня — это скорее публичная альфа, чем что-то еще.
Далее буду допиливать фичи и, главное, шлифовать стилизацию. Но делать это получится не быстро, поскольку проверять буду не на сферическом в вакууме сайте, а на своем живом — параллельно с редизайном…
Upd по GitHub Actions
Так и не удалось пока подружить плагин с ImageMagick v6. Пришлось через одно место ставить v7. Вероятно, буду все-таки уже в ближайшее время делать сборку через собственный контейнер, иначе слишком много бубнов сотрется…
AI-функции в Darktable 5.6
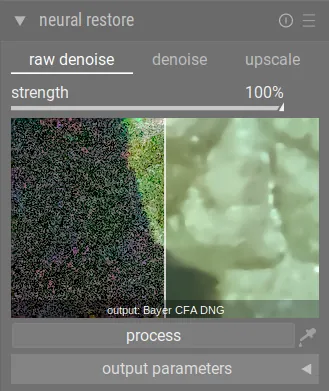
Недавно вышел Darktable 5.6.0. Там довольно много нового и интересного, но, конечно, главное, что обращает на себя внимание — это AI-функции. Имеются: шумоподавление в RAW, просто шумоподавление, апскейл (т.е. увеличение картинки) и маски. Маски я пока не смотрел — я ими как-то вообще не пользуюсь и не очень понимаю, что проверять. Шумодавами и апскейлом я, правда, тоже почти не пользуюсь, но куда смотреть — представляю.
Что дают?
Итак. «raw denoise», «denoise» и «upscale». Как можно видеть на скриншоте, они объединены в один модуль, и это не модуль обработки, он не участвует цепочке обработки и не попадает в историю, это служебный модуль, и находится он в левой панели.
По кнопке «process» генерируется отдельный новый файл — TIFF в случае «denoise» и «upscale», и DNG — в случае «raw denoise». По умолчанию он размещается рядом с исходным и сразу регистрируется в библиотеке.
За исходник «raw denoise» берет исходное состояние RAW-файла, тогда как «denoise» и «upscale» — результат всех примененных обработок. Что, безусловно, логично, но не консистентно. К тому же конкретно для «denoise» это неудобно — по идее это действие должно быть внутри цепочки, ближе к началу… Я недоучел этот момент, когда делал свои тесты (о чем ниже), но переделывать не буду — «правильный» порядок действий слишком заморочный, чтобы реальный пользователь им занимался.
Где взять?
Тут есть засада: если вы как порядочный человек просто обновитесь из своего дистрибутива, не факт, что новые фичи у вас появятся. У меня в Gentoo, например, не появились. Требуется сборка с дополнительным флагом, и когда мейнтейнеры разберутся — неизвестно. Поэтому самый простой способ — скачать официальный релиз с GitHib. Для Linux там имеется AppImage, и он у меня заработал.
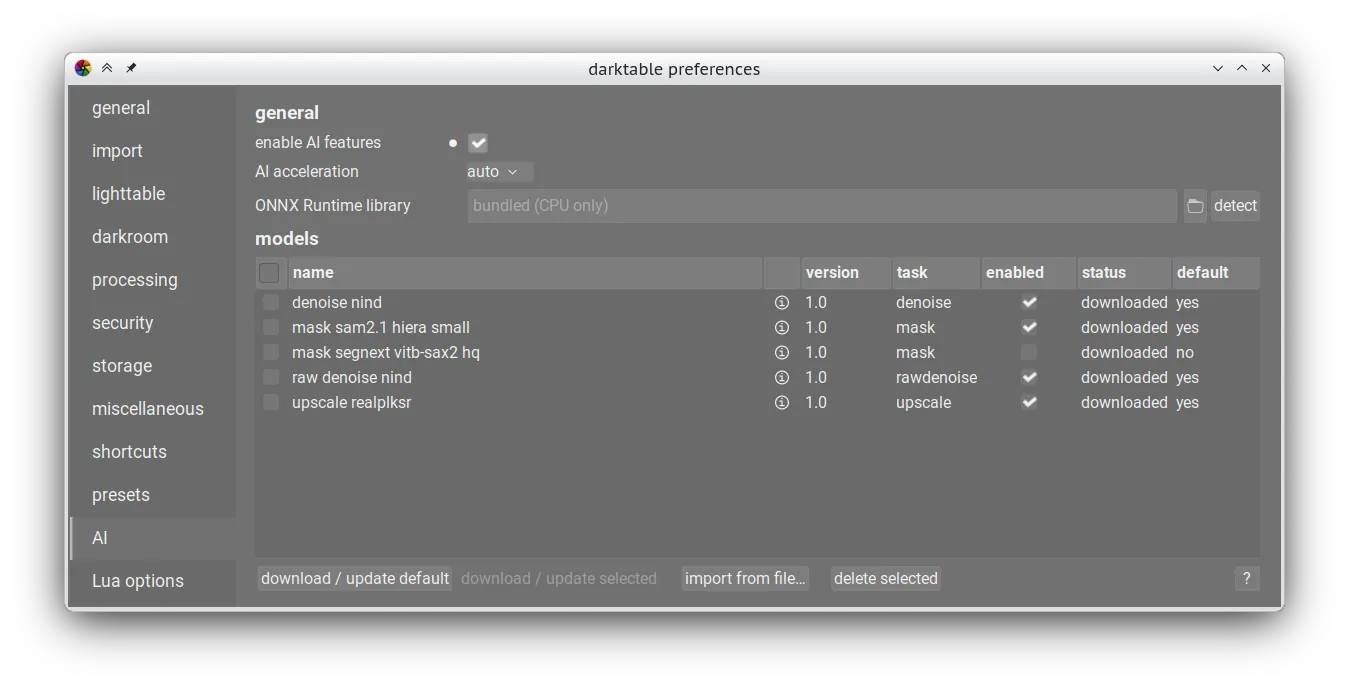
Затем нужно зайти в настройки.
-
Включаем вверху галочку «enable AI features».
-
Скачиваем модели. Все, или только дефолтные.
-
Закрываем Darktable и запускаем его снова.
Отдельный вопрос: как включить выполнение на GPU. По идее, нужно установить ONNX и радоваться, но у меня не получилось — ONNX установил, но он не цепляется. Для пробы это не критично, да и для использования — не так, чтобы очень — если нужно обработать небольшое количество фотографий, скорость на CPU вполне терпима.
Что получилось?
- TL;DR
-
-
Как работает raw denoise мне в целом понравилось, это сильно лучше шумоподавления в стандартных модулях.
-
А вот denoise просто на высоких ISO порождает артефакты. Отчасти эти артефакты могут усиливаться тем, что у меня по умолчанию включен локальный контраст, а denoise, как сказано выше, берет уже обработанное изображение.
-
Что касается upscale… Я не понял. Если брать 100% кроп, то какого-то улучшения деталей в сравнении с тупым увеличением при экспорте (там можно разрешить увеличение). Общая картинка выглядит пошарпленной, но это опять же может быть вызвано двойным применением локального контраста.
-
Ниже много тестовых картинок.
iNatGet v0.9.2 и его практическое применение
Версия 0.9.0.18
Итак, финальные отчеты по своим районным проектам на iNaturalist я сформировал, пользуясь уже новой версией inat-get. Сразу выяснилось, что версия 0.9.01, несмотря на то, что я старался для базовых вещей писать тесты, никуда не годится. Впрочем, это нормально на данном этапе (ранней беты). В результате, отлаживая на реальных данных, я дошел до версии 0.9.0.18 — уже вполне рабочей.
Полученными отчетами я вполне доволен. Примеры:
В подвале скриптов можно разглядеть мелким шрифтом, что сгенерированы они версией 0.9.0.15, а не .18. Это потому, что самые последние исправления в ветке 0.9.0 касались исключительно оптимизаций, и на результат не влияли.
Средств для удобного формирования отчетов все еще нет, пишу текстом в файлы, так что скрипты отчетов получились довольно развесистые. Я их поместил в отдельный репозиторий ing-sv-districts — можно полюбоваться, хотя структура там сильно так себе…
Версия 0.9.2
А здесь добавлена довольно мелкая фича — поддержка ERB, как в качестве шаблонов, вызываемых из пользовательских скриптов, так и в качестве пользовательских скриптов как таковых. Не то, чтобы это было существенное улучшение, но может, кому и пригодится.
Переводить районные скрипты на этот механизм я не стал, поскольку это ничего нового не дает. Впрочем, возможно, имело бы смысл для дополнительной отладки…
Промежуточные итоги
В общем и целом, текущая архитектура вполне годная, от главных тормозов версии 0.8.x удалось избавиться, основной упор по времени
идет в скорость интернета, причем обновления, как и задумано, берутся инкрементно — через параметр updated_since, что резко ускоряет
повторные запросы.
Но работа с локальной БД оставляет желать лучшего, группировочные запросы промахиваются мимо индексов, причем даже группировки по пользователям, которые самые простые по своему внутреннему устройству… Что ж, значит следующая итерация — 0.9.4, запланированная для решения именно этих проблем — запланирована не зря. Заметные тормоза, впрочем, видны только на генерации итоговой сводки — она сейчас занимает у меня пару часов, что печально, конечно, но по сравнению с 0.8.x — просто прекрасный результат.
Что порадовало — уже отлаженный на SQLite вариант на PostgreSQL заработал сразу — спасибо Sequel. Скорость работы на разных СУБД практически не отличается. Нужны, конечно, аккуратные замеры, но в целом разницу можно игнорировать.
Что дальше?
Общий роадмап имеется на вики проекта — Roadmap. Кстати, я тут «навайбкодил» генератор роадмапов из Issues и Milestones — action-is-roadmap — довольно прикольно получилось, люблю наглядность. Даты майлстоунов проставлены от фонаря — чисто для упорядочения, как обещания их воспринимать точно не стоит.
А если не вдаваться в детали, то ключевые задачи такие:
-
Оптимизация запросов.
Не знаю, насколько удастся их ускорить, но желательно выжать все возможное.
-
Доделать кэширование.
-
Удобный конструктор отчетов.
Чтобы не нужно было заморачиваться на оформление в пользовательских скриптах. Писать их, думая только о логике, причем в терминах множеств и выборок.
-
Доделать работу с прочими данными.
Пока реализованы далеко не все возможные запросы и фильтры, есть куда развиваться. И здесь нужно будет не забывать об оптимальности запросов.
Наверное, по ходу дела будут появляться новые задачи, и уж точно — находиться новые баги…
iNatGet v0.9.0
Что ж… Вот я и зарелизил 🌿 iNatGet v0.9. Через два с небольшим года после v0.8, и через примерно год после последней версии — v0.8.0.16. Обо всех этих минорных корректирующих версиях я ничего не писал, главным образом потому, что там мучительно правились мелкие баги, а нормальная работа требовала глобального рефакторинга (т.е. переписать заново с нуля), на который никак не находилось времени.
Однако все это время я не прекращал пользоваться своей программой, регулярно формируя отчеты для своих проектов1 на iNaturalist. Таким образом я постепенно уточнял свое понимание того, как это в принципе должно работать и где у меня провалы в архитектуре. Плюс развитие нейросетей… В проекте ни строчки сгенерированного кода, но для консультаций и ревью я пользовался различными LLM очень активно2, что и позволило сравнительно быстро написать новую, полностью переделанную, версию.
Если версии v0.8.x я характеризовал как альфа-версии, то ветка v0.9.x пусть будет бетой, но пока — очень ранней бетой…
Коротко о том, что это за проект вообще, можно прочитать в README-ru.md в репозитории.
-
См. журналы проекта «Биоразнообразие районов Свердловской области» и его дочерних. ↩
-
О своем отношении и подходе к использованию нейросетей я подробно писал в посте: «Заметки об LLM и нейросетях вообще». ↩
Автодокументирование моделей Sequel
Набросал предварительную версию YARD-плагина для автодокументирования Sequel-моделей — yard-is-sequel.
Существующий yard-sequel с современными версиями YARD/Ruby/Sequel не работает.
Мой вариант, конечно, не может пока похвастаться полнофункциональностью (версия 0.8.0 — это ранняя альфа), но кое-что самое важное умеет:
-
Генерирует список ассоциаций:
many_to_many,many_to_oneиone_to_manyс корректными ссылками на типы. -
Генерирует список полей. Также с типами, но тут есть нюансы…
-
Маппинг типов полей требует доработки. Кроме того, типы, не поддерживаемые SQLite, скорее всего, не будут нормально обрабатываться в принципе.
Поля берутся из
Database#schemaна созданной in-memory SQLite базе данных. Было бы хорошо, безусловно, брать их непосредственно из миграций, но пока непонятно, как это сделать. -
Путь к миграциям следует указать через переменную окружения.
-
Чего нужно доделать?
-
Отрефакторить и упростить обработку ассоциаций.
-
Расширить обработку типов в полях и сделать ее менее хрупкой. Сейчас есть подозрение, что минорная смена версии Sequel может всё поломать…
-
Добавить возможность брать схему из отдельно сохраненного файла (в формате JSON, скорее всего).
Но надо понимать, что я буду что-то править и дорабатывать только постольку, поскольку мне это самому нужно… Однако, если кто-то предложит свои пулл-реквесты, или хотя бы подробные баг-репорты, отнесусь со вниманием.
Об инвалидацию кэша
Как известно, в программировании есть только две реально сложные задачи: именование переменных и инвалидация кэша1. С первой мы сделать ничего не можем, со второй, конечно, тоже, но что-то делать приходится…
И вот в процессе большого рефакторинга inat-get я в очередной раз задумался. Суть тут вот в чем: данные, которые требуется получать из API iNaturalist — очень большие (зависит от целей, конечно, но они могут быть очень большими), и логично их закэшировать в локальной базе данных. Естественно, кэшированные данные нужно обновлять.
Есть прекрасный параметр updated_since в запросах к API, т.е. мы храним у себя информацию о сделанных запросах, и когда
нам нужно получить новые данные по тем же условиям, указываем дату/время предыдущего запроса в этом параметре. Но полностью
проблему это не решает: updated_since не отменяет (и не должен отменять) все остальные параметры запроса, т.е. те
наблюдения, которые выпали из запроса, в выборку не попадут. И останутся в локальной БД в старом состоянии.
Ну, то есть, выбрали мы, например, данные по проекту, который фильтрует наблюдения с quality_grade=research, а потом
пришел добрый человек и заметил, что в наблюдении культурное растение. Наблюдение выпадает из проекта, но мы об этом
не можем узнать через обновление…
Какие есть пути решения? Вижу несколько вариантов, ни один из которых меня не устраивает полностью…
-
Автор этой фразы, предположительно, Фил Карлтон (Phil Karlton), ведущий инженер компании Netscape. ↩
Показаны 10 записей из 92